In sintesi
- PlayStation 4 esegue Qwen3.5-9B senza cloud. Il progetto open source Garlic LLM porta un modello da nove miliardi di parametri sulla GPU della console Sony.
- Fino a 43 token al secondo nella generazione di codice. Lo sviluppatore dichiara 31–39 token al secondo nelle conversazioni testuali, grazie a quantizzazione e accesso diretto alla GPU.
- Funzionano anche voce e dettatura in italiano. Il software richiede una console modificata con GoldHEN e non è un prodotto ufficiale Sony.
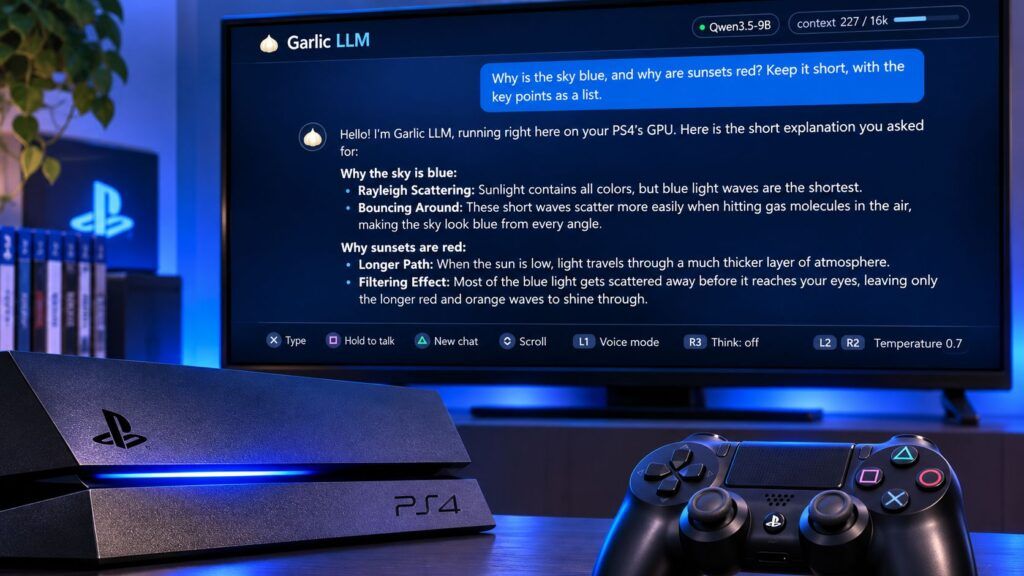
Una PlayStation 4 del 2013, opportunamente modificata, riesce a eseguire un modello linguistico da nove miliardi di parametri senza collegarsi a Internet né affidarsi a un computer esterno. Il progetto open source Garlic LLM, sviluppato da Leonardo Alegría, porta Qwen3.5-9B sulla GPU AMD della console Sony e dichiara una velocità compresa tra 31 e 39 token al secondo nelle conversazioni testuali, con punte di 43 token al secondo nella generazione di codice. Non è una nuova funzione ufficiale PlayStation né un servizio distribuito da Sony: richiede una console modificata con GoldHEN e un software creato specificamente per l’hardware della PS4. La novità non è soltanto far girare un chatbot su un dispositivo vecchio di tredici anni, ma dimostrare come un’implementazione molto vicina alla GPU possa recuperare capacità di calcolo apparentemente precluse dalle normali interfacce software.
Cosa leggere
Nove miliardi di parametri dentro una console da 8 GB
La PS4 dispone di 8 GB di memoria condivisa tra CPU e GPU, una quantità insufficiente per caricare senza compressione un modello da nove miliardi di parametri. Garlic LLM aggira il problema attraverso una quantizzazione mista: gran parte dei pesi utilizza quattro bit, mentre alcune grandi matrici impiegano una rappresentazione a tre bit con scale. Il modello occupa così circa 4,5 GiB, mentre una cache dell’attenzione anch’essa a quattro bit permette una finestra contestuale di 16.000 token, inferiore ai 256.000 del modello originale.
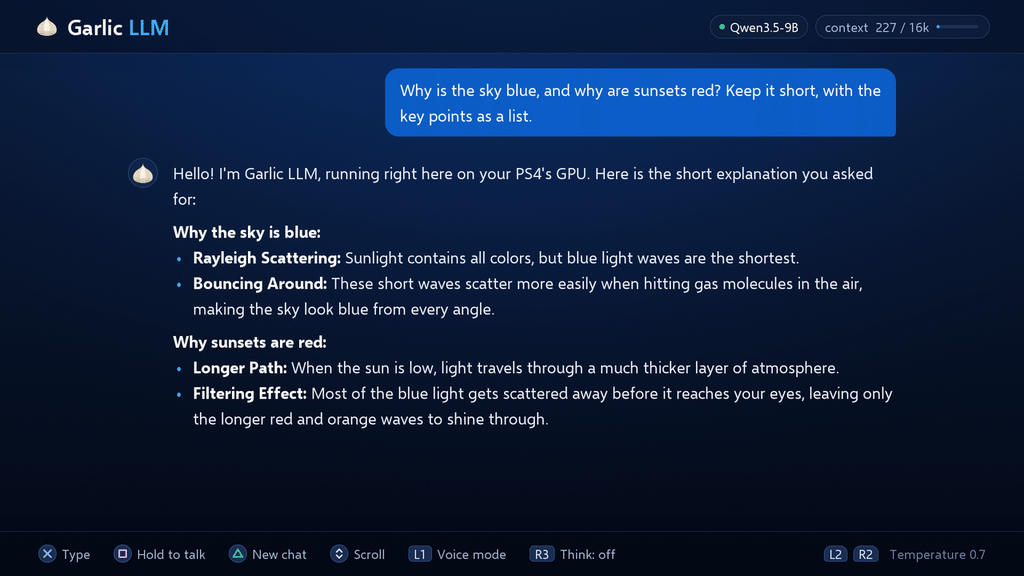
Con i componenti per riconoscimento e sintesi vocale il fabbisogno dichiarato arriva a circa 5,23 GiB. La scelta comporta compromessi sulla precisione e sul contesto disponibile, ma consente di mantenere l’inferenza nella memoria della console. È lo stesso modello Qwen3.5-9B già impiegato in altri contesti, tra cui la sperimentazione antifrode di Coinbase con Qwen3.5-9B, sebbene qui l’obiettivo sia completamente diverso: dimostrare l’esecuzione su hardware consumer datato.
Leggi anche: Perplexity porta modelli e agenti AI offline sui Mac.
Accesso diretto alla GPU AMD senza un normale driver AI
L’aspetto tecnico più originale è il collegamento diretto con la GPU basata sull’architettura AMD Graphics Core Next. Il progetto utilizza kernel di calcolo scritti in OpenCL C e compilati con LLVM, mentre l’applicazione costruisce autonomamente pacchetti di comandi PM4, che normalmente verrebbero generati da un driver grafico. Non dipende quindi da una tradizionale infrastruttura per l’inferenza AI né da un porting di Vulkan o llama.cpp sulla PS4. Il processore centrale si occupa dell’interfaccia, della tokenizzazione e della gestione audio; la GPU esegue le operazioni matematiche più pesanti. Il software è stato realizzato con la toolchain open source OpenOrbis. Il caso ricorda quanto sia importante distinguere potenza teorica e prestazioni effettive: anche il precedente sullo sblocco dei calcoli Tensor della Nvidia RTX 4090 mostra che accelerare singole operazioni non garantisce automaticamente più token generati al secondo.
Chat fino a 39 token al secondo, codice fino a 43
Il risultato più immediato riguarda la velocità dichiarata dallo sviluppatore. Su una PS4 standard o Slim il modello produce 31–39 token al secondo in chat, mentre può raggiungere 43 token al secondo sul codice. La differenza è attribuita anche alla tecnica di speculative decoding: un componente del modello propone fino a due token in anticipo e il modello principale li verifica. In modalità vocale, quando vengono utilizzati anche i modelli audio, la velocità di generazione scende a circa 22 token al secondo. Si tratta di misurazioni comunicate dal progetto, non di benchmark indipendenti con prompt e metodologia pubblicati in modo comparabile. Il repository segnala test su PS4 standard e Slim con firmware 11.52, oltre a riscontri di utenti su altre versioni e su PS4 Pro, per le quali lo sviluppatore non dichiara prove personali.
Risposte vocali in italiano e programmi Python eseguiti localmente
Garlic LLM non si limita alla tastiera. Integra Chatterbox per rispondere a voce in sette lingue, compreso l’italiano, e Parakeet TDT 0.6B v3 per la dettatura in 25 lingue europee. Il progetto dichiara anche una modalità capace di generare programmi ed eseguirli tramite MicroPython sulla stessa console. Secondo la documentazione disponibile nel repository originale Garlic LLM, l’elaborazione avviene interamente sul dispositivo, senza trasferire richieste a un cloud durante l’uso. Questa architettura evita la dipendenza da una connessione continua, ma non equivale a una verifica indipendente della sicurezza del software e dei programmi generati. L’applicazione è gratuita e aperta, mentre GoldHEN rimane un requisito esterno: il progetto non fornisce un exploit e non rappresenta una funzione supportata da Sony.
Continua con: le sperimentazioni sull’AI eseguita su dispositivi Android TV.
Il significato oltre il modding PlayStation
La PS4 non diventa un’alternativa alle workstation moderne né una piattaforma AI supportata ufficialmente. L’esperimento dimostra però che la combinazione di modelli relativamente compatti, quantizzazione e accesso diretto all’hardware può estendere la vita computazionale di dispositivi considerati superati. Il vincolo è duplice: prestazioni da confermare su configurazioni differenti e necessità di modificare la console, con possibili problemi di compatibilità e sicurezza. La parte interessante per l’industria riguarda la riduzione della dipendenza dal cloud: se un modello da nove miliardi di parametri riesce a rispondere localmente su una GPU progettata nel 2013, l’efficienza del software può essere importante quanto l’acquisto di nuovi acceleratori. Resta una dimostrazione tecnica, non una promessa di disponibilità generalizzata per tutti i possessori di PlayStation.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.