In sintesi
- AWS Lambda supporta le GPU e i runtime gestiti dai clienti: le aziende possono eseguire inferenza AI e applicare aggiornamenti centralizzati senza amministrare direttamente i server, mantenendo però nuove responsabilità sulla sicurezza.
- AWS Glue automatizza gli aggiornamenti e ottimizza Apache Spark con l’AI: i passaggi di versione richiedono approvazione, mentre l’agente di ottimizzazione promette risparmi del 24-31% nei benchmark condotti da AWS.
- Amazon OpenSearch Memory arriva anche a Francoforte: la memoria persistente per gli agenti AI permette di recuperare informazioni dalle conversazioni precedenti e ridurre il consumo di token.
Amazon Web Services cambia il modo in cui le aziende possono eseguire applicazioni, gestire dati e sviluppare agenti di intelligenza artificiale, introducendo cinque funzionalità che intervengono direttamente su costi, prestazioni e controllo dell’infrastruttura cloud. Il 18 novembre 2026 AWS ha annunciato il supporto alle GPU per Lambda Managed Instances, la possibilità di creare runtime Lambda gestiti direttamente dai clienti, gli aggiornamenti automatici delle versioni di AWS Glue, un agente AI per ottimizzare i processi Apache Spark e la disponibilità generale di Amazon OpenSearch Memory, servizio che conserva il contesto delle conversazioni utilizzate dagli agenti AI. Le novità riguardano tecnologie differenti, ma descrivono una strategia comune: trasferire una parte crescente delle attività di manutenzione, configurazione e ottimizzazione verso servizi cloud gestiti, lasciando alle aziende il governo delle applicazioni e delle informazioni trattate. Per il mercato italiano il punto decisivo riguarda la disponibilità europea, i costi operativi e le conseguenze sulla sicurezza dei dati. Non tutte le funzionalità hanno infatti gli stessi requisiti, lo stesso modello economico o la medesima distribuzione geografica, e l’automazione non elimina la necessità di controllo umano.
Cosa leggere
AWS Lambda introduce le GPU: inferenza AI e video direttamente nel serverless
La prima novità riguarda AWS Lambda, che estende le proprie capacità ai carichi di lavoro accelerati attraverso GPU NVIDIA disponibili sulle istanze Amazon EC2 della serie G. Il nuovo supporto interessa le Lambda Event Functions eseguite su Lambda Managed Instances, un ambiente nel quale AWS gestisce provisioning, scalabilità e integrazione degli eventi, mentre le applicazioni utilizzano risorse computazionali EC2 specializzate. Secondo il comunicato ufficiale AWS sul supporto GPU, la funzionalità è disponibile per le famiglie G4dn, G5, G6, G6f, Gr6, Gr6f e G6e, con ulteriori tipologie di istanze previste successivamente. Le funzioni accelerate vengono distribuite attraverso immagini container conformi allo standard OCI, eliminando la necessità di configurare manualmente driver GPU, versioni CUDA e infrastrutture Kubernetes. La differenza rispetto a un cluster GPU tradizionale consiste nella possibilità di collegare l’elaborazione direttamente agli eventi AWS: il caricamento di un file su Amazon S3, l’arrivo di un messaggio su SQS oppure una richiesta attraverso API Gateway possono attivare immediatamente un processo accelerato.
AWS indica come principali applicazioni inferenza di modelli personalizzati, riconoscimento vocale, elaborazione documentale, visione artificiale, rendering 3D, transcodifica video e simulazioni scientifiche. La piattaforma viene proposta soprattutto per l’inferenza, non per l’addestramento di grandi modelli fondamentali già disponibili attraverso servizi dedicati come Amazon Bedrock. Gli ambienti possono utilizzare da 3 a 48 GB di memoria dell’acceleratore, gestire fino a 48 richieste concorrenti per ambiente di esecuzione e impiegare immagini container fino a 32 GB, con altrettanto spazio temporaneo disponibile. Per le invocazioni asincrone e quelle originate da Event Source Mapping rimane supportata la durata massima di 90 minuti, già introdotta nei mesi precedenti e approfondita nell’analisi sull’estensione dei timeout di AWS Lambda. Questo limite non va esteso alle chiamate sincrone, che mantengono vincoli differenti. Il risultato è una piattaforma capace di sostenere elaborazioni più pesanti senza obbligare gli sviluppatori a costruire una seconda infrastruttura dedicata esclusivamente alle GPU.
Lambda esegue un modello AI senza gestire server, ma le GPU non diventano gratuite
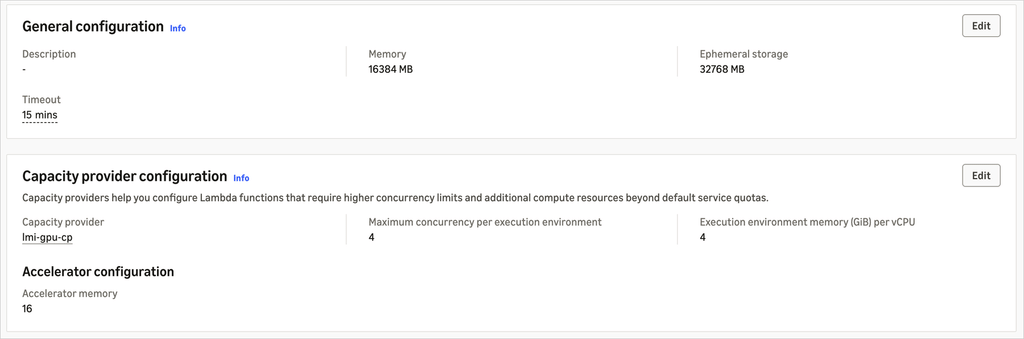
AWS dimostra la nuova capacità utilizzando Qwen2.5-1.5B-Instruct, modello linguistico open source distribuito attraverso Hugging Face, eseguito su una funzione Lambda accelerata. La configurazione parte da un’immagine base che include vLLM, PyTorch, Transformers e CUDA: lo sviluppatore deve indicare il modello attraverso la variabile MODEL_ID, pubblicare l’immagine su Amazon ECR e configurare un capacity provider con le istanze GPU consentite. Nell’esempio AWS, il sistema utilizza istanze G5, G6 e G6e, assegna 16 GB di memoria GPU e configura quattro richieste concorrenti per ambiente. vLLM mantiene una singola copia del modello nella memoria dell’acceleratore e gestisce le richieste attraverso batching, evitando di caricare ripetutamente gli stessi pesi. AWS riferisce di aver completato il passaggio dalla configurazione all’endpoint operativo in circa dieci minuti, un risultato riferito alla dimostrazione e non una garanzia applicabile a tutti i modelli o alle diverse condizioni di capacità.
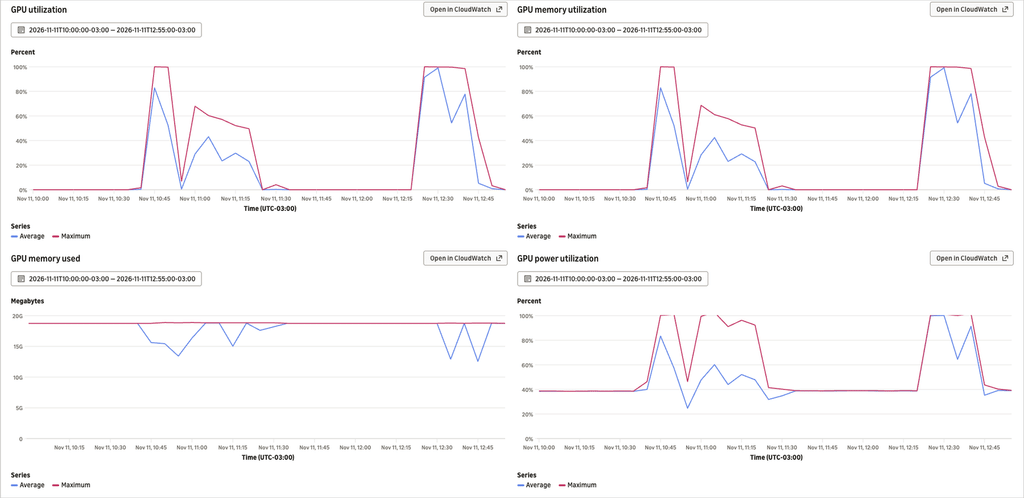
Il vantaggio operativo non equivale però al pagamento esclusivo del tempo di inferenza. Le GPU vengono fornite attraverso istanze EC2 sottostanti e il prezzo comprende il costo delle risorse computazionali, una commissione di gestione del 9,75% per le istanze GPU e le normali tariffe per le richieste Lambda. AWS permette di utilizzare Savings Plans e Reserved Instances compatibili, mentre CloudWatch espone metriche dedicate all’utilizzo della GPU, della memoria e della potenza assorbita. La convenienza dipende quindi dalla saturazione dell’acceleratore, dalla frequenza delle invocazioni e dalla capacità di condividere una GPU tra richieste simultanee. Per un’impresa italiana che elabora documenti riservati o contenuti multimediali, il vantaggio principale potrebbe essere la riduzione delle attività amministrative, non necessariamente una diminuzione automatica della fattura. È inoltre necessario verificare la disponibilità effettiva delle istanze GPU nella Regione AWS scelta, perché l’annuncio non costituisce una conferma di supporto identico in tutti i data center europei.
Leggi anche:
AWS elimina i cold start Java con Lambda Managed Instances e celebra 20 anni di SQS
Lambda permette alle aziende di gestire runtime, patch e certificati senza aggiornare ogni funzione
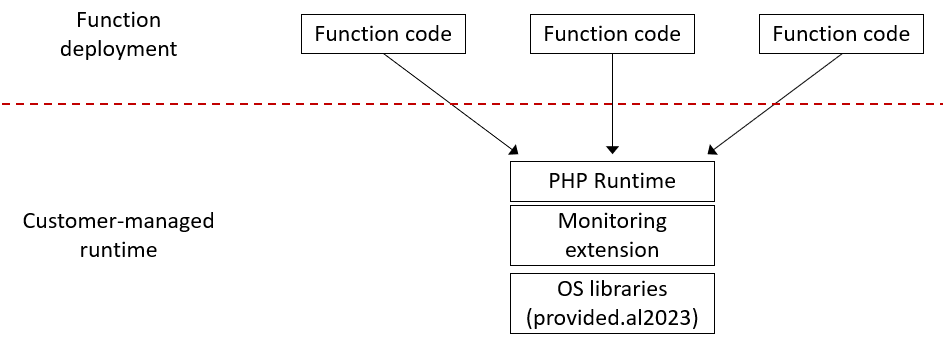
La seconda innovazione riguarda il controllo degli ambienti software. Con customer-managed runtimes, AWS Lambda permette alle aziende di costruire e distribuire runtime centralizzati che comprendono linguaggi di programmazione, librerie, certificati, strumenti di monitoraggio e componenti di sicurezza. Come spiegato nella documentazione tecnica AWS sui customer-managed runtimes, il modello separa due responsabilità: il runtime publisher crea e mantiene l’ambiente di esecuzione, mentre il runtime consumer sviluppa e distribuisce le singole funzioni. Un’organizzazione può così predisporre un runtime PHP, Bun oppure R, includere certificati aziendali e sistemi di osservabilità, quindi renderlo disponibile alle applicazioni attraverso un riferimento condiviso. Gli sviluppatori continuano a distribuire semplici archivi ZIP e non devono necessariamente conoscere il processo di costruzione dei container.
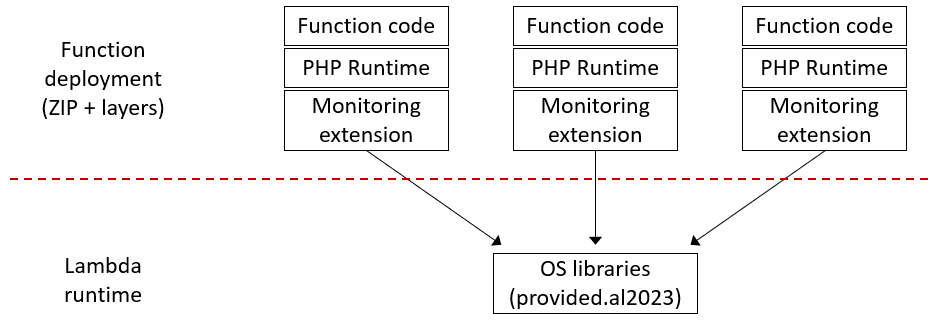
L’elemento più importante riguarda gli aggiornamenti. Ogni runtime viene pubblicato attraverso una versione immutabile, costruita a partire da un’immagine conservata su Amazon ECR. Le funzioni fanno riferimento a un alias, che può essere spostato dalla versione precedente a quella aggiornata. Quando viene creato un nuovo ambiente di esecuzione, Lambda utilizza la versione associata all’alias, senza richiedere un nuovo deployment per ciascuna funzione. Per una grande azienda che gestisce migliaia di funzioni serverless, questo modello permette di aggiornare centralmente librerie, strumenti di monitoraggio o componenti crittografici, organizzando il rilascio per ambiente e Regione. AWS prevede anche metriche CloudWatch specifiche, RuntimeInvocations e RuntimeInvocationErrors, utili per confrontare il comportamento delle versioni e interrompere un aggiornamento che introduce regressioni. La funzionalità è dichiarata disponibile nelle Regioni AWS commerciali, ma la risorsa runtime rimane regionale e deve essere creata separatamente dove viene utilizzata.
La gestione autonoma dei runtime sposta la responsabilità della sicurezza sul cliente
Il controllo diretto del runtime introduce una responsabilità che non deve essere sottovalutata: AWS non applica automaticamente le patch ai customer-managed runtimes. L’azienda che pubblica l’ambiente deve ricostruire le immagini, incorporare gli aggiornamenti, effettuare verifiche di compatibilità e distribuire le nuove versioni. La possibilità di continuare a utilizzare un runtime anche dopo la dismissione della corrispondente versione gestita da AWS può risultare utile durante migrazioni complesse, ma comporta l’obbligo di mantenere autonomamente il software. Un runtime non aggiornato può trasformarsi in un punto di vulnerabilità condiviso da centinaia di funzioni. La centralizzazione riduce gli interventi ripetitivi, ma concentra anche l’impatto potenziale di un errore o di una compromissione.
AWS riconosce inoltre un rischio specifico della software supply chain: chi controlla il runtime può introdurre codice negli ambienti che lo utilizzano. Di conseguenza, condividere un runtime fra account differenti richiede una relazione di fiducia equivalente a quella concessa a chi amministra il software applicativo. Il controllo degli accessi passa attraverso policy delle risorse, permessi IAM e regole organizzative che possono limitare l’utilizzo ai publisher approvati. AWS introduce anche protezioni contro le cancellazioni accidentali, con periodi configurabili da 7 a 30 giorni, ma un alias o una versione destinati alla cancellazione possono comunque rendere inattive le funzioni che li utilizzano. Non sono previsti costi aggiuntivi per la gestione dei runtime, mentre restano applicabili le tariffe ordinarie di Lambda e quelle di conservazione delle immagini su ECR. La novità non elimina quindi il lavoro di sicurezza: permette piuttosto di concentrarlo all’interno di un processo aziendale controllabile e verificabile.
AWS Glue automatizza gli aggiornamenti di Apache Spark ma richiede l’approvazione
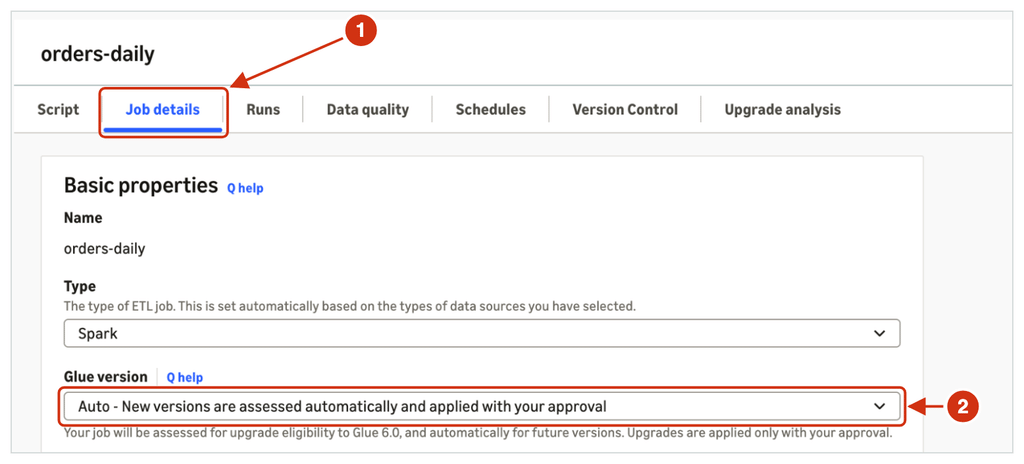
Il terzo intervento riguarda AWS Glue, piattaforma serverless utilizzata per integrare, trasformare e preparare dati attraverso pipeline ETL basate su Apache Spark. Gli aggiornamenti dei runtime possono essere particolarmente onerosi per le imprese che gestiscono centinaia di processi, perché ogni nuova versione richiede verifiche sulle dipendenze, sulle librerie Python e sul comportamento delle trasformazioni. AWS introduce quindi automatic version upgrades, funzionalità che permette di impostare il parametro GlueVersion su auto. Il servizio analizza la compatibilità del processo con la versione stabile più recente, verifica eventuali modifiche incompatibili e produce un rapporto da sottoporre all’amministratore. Soltanto dopo l’approvazione esplicita viene avviato l’aggiornamento.
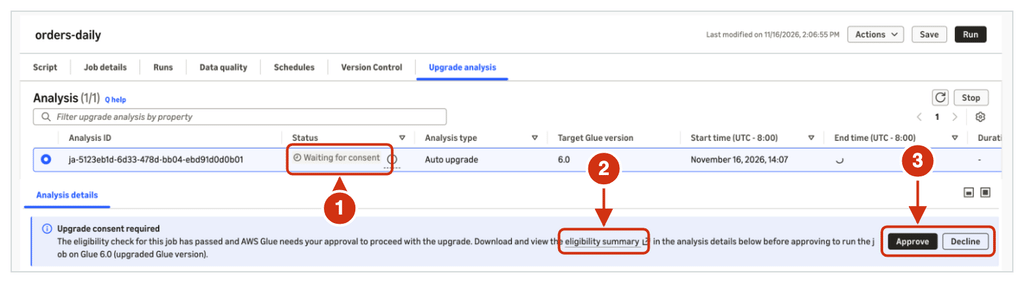
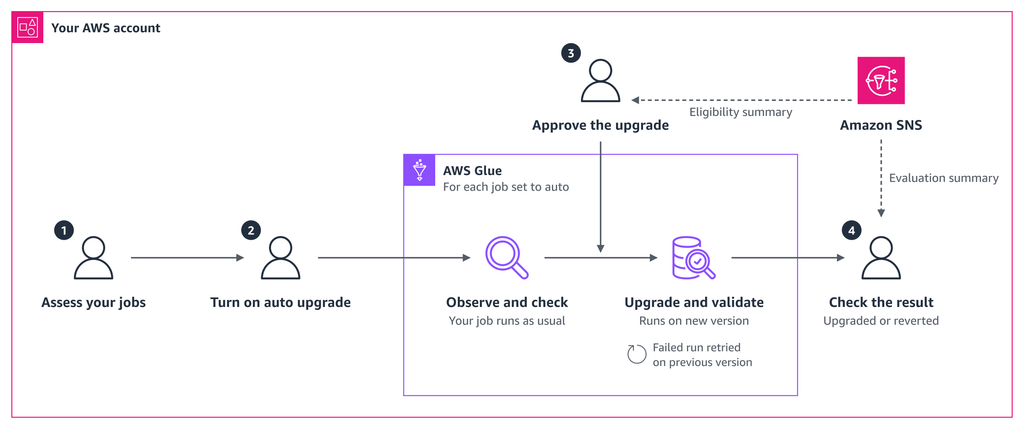
Nel comunicato AWS sugli aggiornamenti automatici di Glue il processo viene descritto come una sequenza controllata: analisi della compatibilità, richiesta di consenso, esecuzione sulla nuova versione, confronto con i risultati precedenti e verifica di correttezza, prestazioni e costi. Se l’esecuzione aggiornata fallisce, Glue può ripetere il lavoro sulla versione precedente e ripristinare la configurazione originaria. La funzionalità non modifica autonomamente il codice dello script e richiede condizioni precise: il job deve utilizzare AWS Glue 2.0 o successivo, appartenere alla categoria Spark ETL, prevedere almeno un tentativo di ripetizione e non utilizzare la coda delle esecuzioni. Deve inoltre essere sicuro ripetere il processo senza introdurre duplicazioni o altre conseguenze sui dati. Per i job che richiedono modifiche al codice, AWS indica un percorso separato basato sugli strumenti di aggiornamento generativo di Apache Spark, da verificare prima di attivare il meccanismo automatico.
Gli agenti AI aggiornano intere flotte Glue, ma non devono approvare modifiche indiscriminate
AWS accompagna gli aggiornamenti automatici con una procedura destinata alle aziende che gestiscono numerosi job. Attraverso un agente AI compatibile con Model Context Protocol, come Kiro o Claude Code, è possibile analizzare un insieme di pipeline, identificare quelle idonee all’aggiornamento e configurare notifiche attraverso Amazon SNS ed EventBridge. L’agente utilizza strumenti dedicati per valutare la compatibilità e mostrare le eventuali condizioni che impediscono il passaggio alla nuova versione. Quando un job risulta aggiornabile, il sistema può configurare il parametro automatico e preparare la richiesta di consenso. AWS indica una finestra di sette giorni per approvare o rifiutare l’aggiornamento proposto.
La possibilità di gestire molte pipeline attraverso istruzioni in linguaggio naturale non equivale ad autorizzare un agente a modificare indiscriminatamente un ambiente di produzione. L’agente mostra i job interessati e richiede la conferma dei cambiamenti, mentre le verifiche sui percorsi di scrittura e sulla sicurezza delle ripetizioni rimangono importanti. Un processo ETL che aggiorna dati contabili, informazioni sanitarie o archivi operativi può produrre conseguenze rilevanti se viene eseguito due volte senza adeguate protezioni applicative. Il nuovo meccanismo permette di ridurre il lavoro amministrativo associato al ciclo delle versioni, ma non sostituisce i controlli sulla correttezza dei risultati. La novità completa il percorso avviato con AWS Glue 6.0, Apache Spark 4.1 e il supporto ad Apache Iceberg v3: dopo aver aggiornato il motore di elaborazione, AWS punta a semplificare il mantenimento delle pipeline sulle versioni più recenti.
Apache Spark ottiene un agente AI che promette risparmi del 24-31%
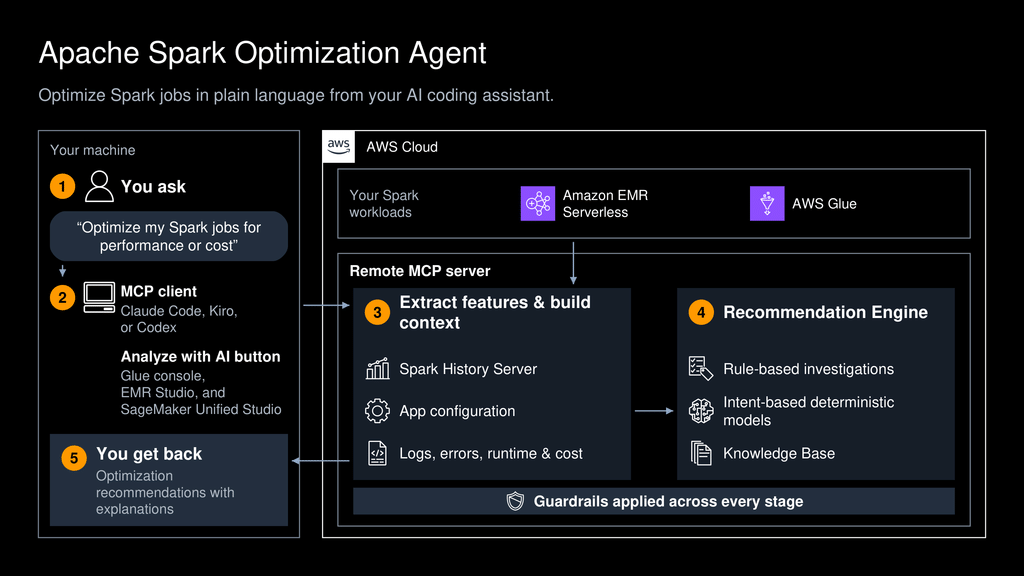
La quarta novità riguarda l’ottimizzazione dei processi Apache Spark eseguiti attraverso Amazon EMR Serverless e AWS Glue ETL. AWS rende generalmente disponibile uno Spark optimization agent che analizza le esecuzioni completate e suggerisce modifiche alle configurazioni per ridurre i costi oppure migliorare le prestazioni. Invece di affidare l’analisi esclusivamente a specialisti Spark, il sistema raccoglie informazioni dalla telemetria, dai log e dalla configurazione dei processi, individua possibili colli di bottiglia e formula raccomandazioni accompagnate dai dati che le giustificano. Il servizio è accessibile attraverso EMR Studio, AWS Glue Studio e il server MCP di Amazon SageMaker Unified Studio, consentendo agli sviluppatori di richiedere un’analisi in linguaggio naturale.
I risultati pubblicati nell’approfondimento AWS sullo Spark optimization agent indicano riduzioni dei costi comprese tra il 24% e il 31% e miglioramenti delle prestazioni dal 23% al 49% su un insieme di oltre cento workload valutati. Per i benchmark derivati da TPC-DS su 3 TB, AWS riporta intervalli ancora più ampi, con risparmi dal 30% al 78% e miglioramenti delle prestazioni dal 32% al 44%. Su TPC-H da 3 TB i risparmi osservati variano dal 10% al 64%. Si tratta tuttavia di risultati ottenuti nei test condotti dal produttore, non di percentuali garantite per qualsiasi pipeline aziendale. L’efficacia dipende dalla configurazione iniziale, dai dati elaborati, dalle operazioni effettuate e dalla versione del servizio utilizzato. Il vantaggio maggiore potrebbe emergere proprio nei processi che non sono mai stati ottimizzati e utilizzano risorse superiori a quelle necessarie.
L’agente Spark osserva i job, ma lascia le modifiche agli amministratori
La caratteristica più importante dell’agente riguarda il suo perimetro operativo. Lo Spark optimization agent lavora in sola lettura: esamina le esecuzioni già completate, confronta le metriche e produce raccomandazioni, ma non modifica autonomamente il codice o le impostazioni dei job. I problemi ricercati comprendono data skew, pressione sulla memoria, utilizzo eccessivo dello shuffle, scritture temporanee su disco, dimensionamento non corretto dei worker, strategie di join inefficienti e organizzazione inadeguata dei file. L’utente può chiedere di privilegiare il costo oppure la velocità, e il sistema cerca di evitare che il parametro non selezionato peggiori oltre determinate soglie. È disponibile anche il confronto con una precedente esecuzione utilizzata come riferimento, particolarmente utile quando una pipeline diventa improvvisamente più lenta.
Le indicazioni prodotte dall’agente vengono suddivise in tre categorie: infrastruttura, relativa alle risorse di calcolo; configurazione, dedicata ai parametri Spark; e dati, che può richiedere modifiche alla disposizione fisica delle informazioni. Le prime due categorie possono spesso essere verificate attraverso una nuova esecuzione, mentre intervenire sulla struttura dei dati richiede controlli più approfonditi, perché può modificare il comportamento delle trasformazioni. AWS precisa che il sistema combina analisi deterministiche, regole tecniche e un modello AI, utilizzando una base di conoscenza costruita sui problemi ricorrenti dei workload Spark. Il produttore dichiara inoltre che i dati dei clienti non vengono utilizzati per addestrare il modello o costruire la base di conoscenza. Il servizio non prevede un costo aggiuntivo per l’utilizzo dell’agente, senza eliminare naturalmente le normali tariffe delle risorse Glue ed EMR. La novità prosegue l’evoluzione già emersa nell’analisi delle ottimizzazioni Spark e delle viste materializzate Apache Iceberg, spostando una parte del lavoro di tuning verso strumenti capaci di interpretare direttamente la telemetria delle applicazioni.
Amazon OpenSearch Memory arriva a Francoforte: gli agenti AI conservano le conversazioni
La quinta innovazione riguarda la memoria persistente degli agenti AI. AWS rende generalmente disponibile Amazon OpenSearch Memory, servizio costruito su OpenSearch Serverless che conserva le interazioni, estrae informazioni significative e permette di recuperare il contesto delle conversazioni precedenti. Il problema affrontato è concreto: un agente utilizzato per assistenza clienti, sviluppo software o gestione documentale deve spesso ricordare decisioni, richieste e informazioni emerse in sessioni precedenti. Trasmettere ogni volta l’intera cronologia al modello aumenta il numero dei token elaborati, rallenta le risposte e può rendere meno efficace il recupero delle informazioni rilevanti.
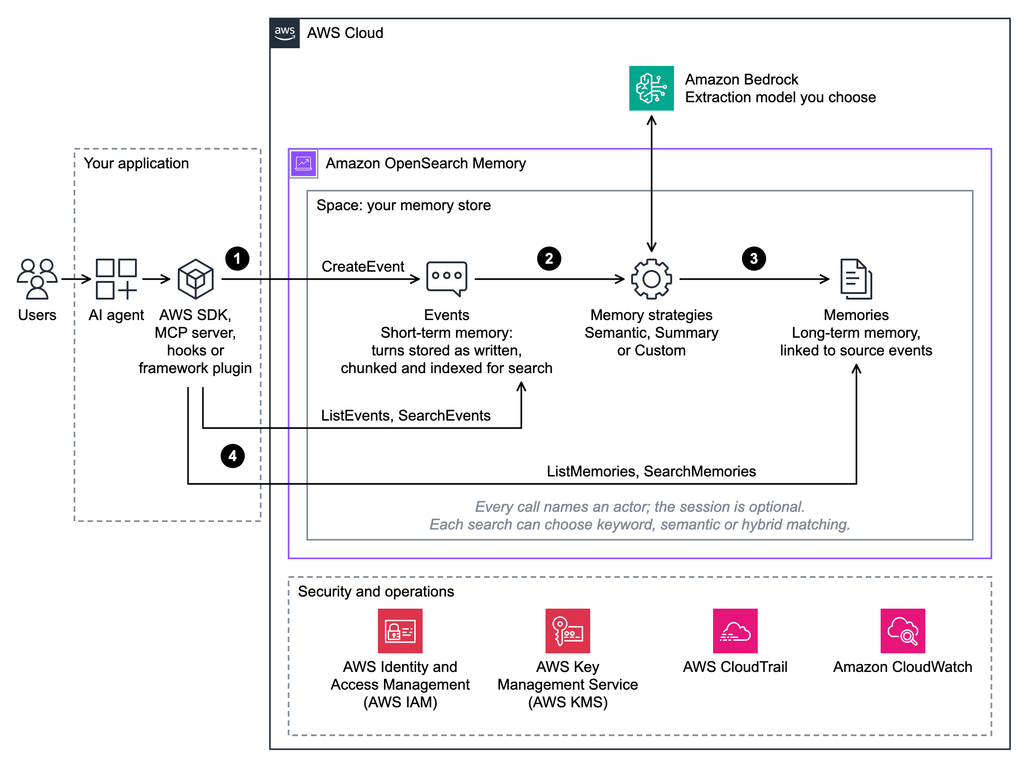
Nel comunicato originale di AWS su Amazon OpenSearch Memory il servizio viene descritto come un archivio che distingue events e memories. I primi conservano le interazioni originali, mentre le seconde rappresentano fatti, preferenze e riepiloghi ricavati dalle conversazioni. Dopo ogni scambio l’applicazione può registrare un evento; OpenSearch Memory lo rende consultabile immediatamente e ricercabile entro pochi secondi, mentre un processo asincrono estrae le informazioni da conservare nel tempo. Prima di generare una risposta, l’agente recupera le memorie pertinenti e le inserisce nel contesto del modello. AWS gestisce indicizzazione, embedding, consolidamento delle informazioni, ricerca e conservazione, riducendo la necessità di costruire un sistema personalizzato.
Per le aziende europee la disponibilità geografica rappresenta il dato più importante. Amazon OpenSearch Memory viene distribuito inizialmente in quattro Regioni: Virginia settentrionale, Oregon, Tokyo e Francoforte. Quest’ultima costituisce il primo punto di accesso europeo dichiarato nell’annuncio e permette alle organizzazioni italiane di valutare l’utilizzo del servizio all’interno di una Regione AWS situata nell’Unione europea. La disponibilità a Francoforte non costituisce però, da sola, una certificazione di conformità al GDPR o una garanzia che ogni componente dell’applicazione rimanga necessariamente nell’UE. Occorre verificare la configurazione dei modelli, le integrazioni esterne, i trasferimenti di informazioni e le condizioni contrattuali applicabili. La novità amplia comunque le possibilità offerte dalla precedente evoluzione di OpenSearch Serverless verso applicazioni e agenti AI.
OpenSearch Memory riduce i token del 92% mantenendo un’accuratezza del 93%
AWS accompagna il lancio con una valutazione basata su LongMemEval-S, benchmark pubblico comprendente 500 domande costruite attorno a informazioni distribuite in circa cinquanta sessioni conversazionali. Nel test, il sistema OpenSearch Memory recupera le trenta memorie ed eventi considerati più pertinenti e li fornisce al modello incaricato di rispondere. La configurazione utilizza Claude Haiku 5.5 per estrarre informazioni, Amazon Titan Text Embeddings per rappresentarle e Claude Opus 5.5 per formulare e valutare le risposte. Il confronto comprende tre modalità: memoria strutturata con ricerca ibrida, recupero dei soli messaggi attraverso BM25 e trasmissione dell’intera cronologia. I risultati mostrano che OpenSearch Memory raggiunge il 93% di accuratezza utilizzando circa 13.500 token per domanda, contro il 95,2% ottenuto fornendo l’intera cronologia, pari a circa 167.000 token. Il metodo tradizionale basato su ricerca BM25 ottiene invece l’88,6% con circa 22.700 token. La configurazione con memorie strutturate utilizza quindi circa il 92% di token in meno rispetto alla cronologia completa, mantenendo un’accuratezza inferiore di 2,2 punti percentuali. La differenza è importante perché consente di ridurre la quantità di contesto trasmessa al modello, senza dover recuperare ogni volta tutte le conversazioni precedenti. Anche questi risultati devono essere letti correttamente. AWS dichiara che i valori provengono da una specifica configurazione sperimentale e da una singola esecuzione, con intervalli di confidenza indicativi di 2-3 punti percentuali. Non dimostrano quindi che qualsiasi applicazione costruita con OpenSearch Memory raggiungerà il 93% di accuratezza né che il risparmio di token sarà identico su ogni archivio. Inoltre, il sistema introduce costi propri per conservazione e recupero delle informazioni. La riduzione dei token utilizzati dal modello può diminuire una componente della spesa, ma il costo complessivo dipende anche dal numero di eventi registrati, dalle ricerche e dalla durata di conservazione delle memorie. AWS include le operazioni di estrazione ed embedding nel modello tariffario del servizio, senza presentarle come attività prive di costo.
Memoria degli agenti AI, accessi IAM e conservazione dei dati: il nodo della sicurezza europea
La memoria persistente porta con sé un problema di sicurezza diverso da quello dei normali chatbot senza storico. Un’informazione salvata oggi può influenzare le decisioni di un agente settimane o mesi dopo, anche quando le condizioni iniziali sono cambiate. OpenSearch Memory affronta questa situazione attraverso il consolidamento delle memorie: quando vengono registrate informazioni nuove, il sistema può aggiornare quelle precedenti invece di conservarle come fatti indipendenti e potenzialmente contraddittori. Le applicazioni possono inoltre creare direttamente memorie derivate dai propri sistemi, come un CRM, mantenendo informazioni sulla provenienza. Il meccanismo non elimina la necessità di controllare la correttezza dei dati salvati, soprattutto quando un agente registra autonomamente conclusioni che potrebbero essere inesatte. AWS utilizza una struttura denominata space, nella quale gli eventi e le memorie vengono associati a un identificativo actor. Le policy IAM possono limitare le operazioni ai dati appartenenti agli utenti autorizzati, mentre le singole sessioni permettono di restringere ulteriormente le ricerche. I contenuti vengono cifrati attraverso AWS Key Management Service, con possibilità di utilizzare chiavi gestite dal cliente. Le chiamate API possono essere registrate da CloudTrail e monitorate attraverso CloudWatch, mentre la durata di conservazione degli eventi e delle memorie è configurabile. Le memorie possono essere mantenute anche senza una scadenza automatica, scelta che richiede particolare attenzione quando vengono trattati dati personali. La questione interessa direttamente aziende italiane e pubbliche amministrazioni che stanno sperimentando assistenti AI per documentazione, servizi agli utenti e processi interni. Persistenza della memoria non deve significare conservazione indiscriminata dei dati. Devono essere definite regole per l’accesso, la cancellazione, la durata della conservazione e la correzione delle informazioni inesatte. Anche un agente limitato a un determinato utente deve poter distinguere ciò che è stato dichiarato in una conversazione da ciò che è stato verificato attraverso una fonte aziendale. La governance della memoria diventa quindi parte della governance dell’agente, come già evidenziato nell’approfondimento sugli strumenti AWS per il controllo delle policy e delle autorizzazioni degli agenti AI.
Continua con:
AWS rende MCP stateless e automatizza migrazioni Spark e processi aziendali
AWS porta gli agenti AI nel ciclo software: AgentCore, Quick e Codex diventano enterprise
AWS automatizza il cloud, ma controllo dei costi e responsabilità restano alle aziende
Le cinque novità annunciate da AWS mostrano un cambiamento nel rapporto tra applicazioni, dati e infrastrutture cloud. Lambda permette di utilizzare GPU senza amministrare direttamente i server e di costruire runtime condivisi, ma mantiene costi legati alle istanze e responsabilità precise sul patching. AWS Glue automatizza la migrazione tra versioni, ma richiede il consenso degli amministratori e controlli sulla ripetibilità dei processi. L’agente Spark può individuare configurazioni inefficienti e proporre risparmi significativi, ma non interviene direttamente sui job e non garantisce i risultati ottenuti nei benchmark. OpenSearch Memory introduce infine un sistema gestito per conservare il contesto degli agenti AI, con una prima disponibilità europea a Francoforte, ma pone nuovi problemi di conservazione, accesso e affidabilità delle informazioni. Per le organizzazioni italiane il vantaggio potenziale consiste nel ridurre il lavoro infrastrutturale ripetitivo e rendere più accessibili strumenti che richiedevano competenze specialistiche, senza dover costruire ogni componente partendo da zero. La contropartita è una maggiore dipendenza dai servizi di gestione, dalle API, dalle policy e dai sistemi di osservabilità del fornitore. Il controllo non scompare: si sposta dalla configurazione manuale dei server alla progettazione dei processi, alla validazione dei risultati e alla gestione delle autorizzazioni. La maturità dell’AI aziendale non si misurerà soltanto dalla capacità di eseguire modelli più rapidamente, ma dalla possibilità di conoscere i costi, verificare le decisioni e governare i dati lungo l’intero ciclo operativo.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.