In sintesi
- Amazon Polly genera voci sintetiche da pochi minuti di registrazione e può far pronunciare testi mai letti dalla persona originale.
- L’italiano è tra le sette lingue supportate, ma l’accesso resta subordinato all’autorizzazione del singolo account AWS.
- Consenso, cifratura e watermark accompagnano il servizio: creare una voce è gratuito, mentre la sintesi viene fatturata a consumo.
Cosa leggere
Amazon Polly estende la clonazione vocale anche all’italiano e permette alle aziende di generare nuovi contenuti audio partendo da pochi minuti di registrazione di una persona consenziente. L’annuncio di Amazon Web Services del 19 novembre 2026 riguarda una funzione del servizio di sintesi vocale Polly: la voce riprodotta può pronunciare frasi mai registrate dal parlante originale, mantenendone le caratteristiche apprese. Non si tratta, però, di uno strumento aperto automaticamente a qualsiasi utente Amazon. AWS parla di disponibilità generale con accesso controllato: alcuni clienti sono già abilitati, gli altri devono richiedere l’autorizzazione. La notizia interessa il mercato italiano perché l’italiano figura tra le sette lingue supportate e perché la tecnologia può cambiare la produzione di messaggi telefonici, audiolibri e contenuti digitali. Il debutto introduce anche una questione sostanziale: chi autorizza l’impiego di una voce, chi controlla la copia sintetica e quali garanzie vengono applicate dopo la sua creazione?
Leggi anche: AWS potenzia Nova Sonic e Bedrock per gli agenti vocali aziendali.
Come si crea la voce: da due a dieci minuti di registrazione
Il nuovo voice cloning utilizza il motore generativo di Amazon Polly, già destinato alla conversione di testo in parlato. AWS raccomanda registrazioni di una sola persona per una durata complessiva di due-dieci minuti, suddivise in segmenti brevi; il servizio accetta fino a dieci file e quindici minuti di audio. Una volta inviato il materiale e dichiarato il consenso, la piattaforma crea un identificativo della voce e avvia una procedura che richiede normalmente cinque-dieci minuti. Da quel momento l’applicazione autorizzata può convertire un nuovo testo in parlato attraverso lo stesso timbro, in tempo reale oppure con un’elaborazione destinata a contenuti lunghi. Non è necessario che il parlante abbia pronunciato in anticipo ogni frase generata. AWS precisa tuttavia che il risultato dipende anche dalle condizioni della registrazione: rumori, riverbero, filtri e stile della lettura vengono riflessi nel modello. Non è quindi una garanzia di imitazione perfetta né un assistente capace, da solo, di conversare o prendere decisioni.
Sette lingue, ma ogni voce ne parla soltanto una
L’italiano è supportato nella variante it-IT, insieme a inglese, spagnolo, tedesco, francese, portoghese e hindi. Il limite più importante è che ogni voce sintetica parla nella lingua in cui è stata registrata: non basta campionare una voce italiana per ottenere automaticamente la stessa persona che legge in tedesco. Per contenuti multilingue AWS prevede voci distinte, registrate e approvate nelle varie lingue. Il servizio è disponibile nelle regioni che supportano il motore generativo di Polly, tra cui Francoforte, Zurigo e Londra. Questo rende la tecnologia tecnicamente utilizzabile da clienti europei autorizzati, ma non dimostra che l’accesso sia stato concesso a tutte le aziende italiane. La distribuzione resta subordinata all’abilitazione del singolo account AWS, non al semplice possesso di un abbonamento o all’esistenza di un profilo Amazon. Il comunicato originale di Amazon Web Services precisa le condizioni di disponibilità e i limiti del servizio.
Il consenso non è facoltativo: watermark e controllo degli accessi
Per creare una voce, il cliente deve confermare di possedere tutti i diritti e i consensi necessari sul parlato utilizzato. AWS richiede una dichiarazione esplicita nelle procedure di creazione e sottopone il servizio alle proprie condizioni sull’uso responsabile dell’intelligenza artificiale e sui dati biometrici. Il punto da distinguere è che la documentazione descrive una conferma resa dal cliente: non afferma che questo passaggio costituisca una verifica indipendente e infallibile dell’identità del parlante.
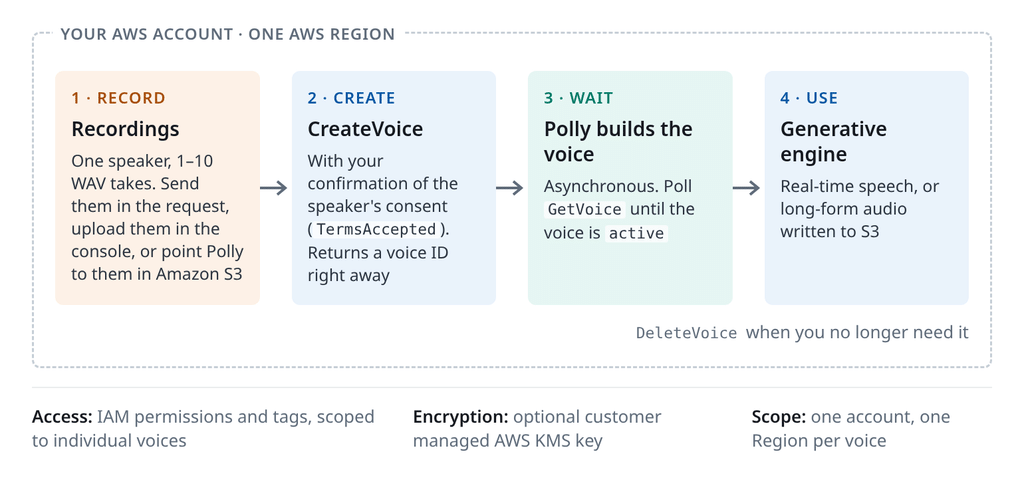
Amazon dichiara inoltre di cancellare la propria copia delle registrazioni originali dopo la creazione e di non utilizzarle per addestrare i modelli Polly. Conserva invece, in forma cifrata, soltanto i dati necessari alla sintesi, finché la voce non viene eliminata. Le voci sono accessibili nell’account AWS che le ha create, con permessi amministrabili tramite IAM e cifratura gestibile anche con chiavi KMS del cliente. L’audio prodotto include un watermark; l’annuncio non ne dimostra però l’efficacia in ogni possibile trasformazione o riutilizzo. AWS raccomanda di conservare prova del consenso e cancellare la voce se l’interessato lo revoca.
Il mercato: assistenza clienti, editoria e contenuti aggiornati
Il valore economico della funzione non consiste nella semplice imitazione di una persona famosa, ma nella possibilità di conservare una voce autorizzata e riconoscibile attraverso molti canali. Amazon cita sistemi telefonici automatici, contact center, applicazioni, annunci nei negozi, dispositivi connessi, audiolibri, corsi, podcast, videogiochi e strumenti di accessibilità. Un’organizzazione può cambiare il testo di un avviso senza convocare nuovamente lo speaker in studio; un editore può aggiornare una narrazione mantenendo un timbro coerente. Per queste applicazioni il controllo editoriale resta essenziale: una voce generata può leggere informazioni nuove, ma ciò non certifica che siano corrette o approvate dalla persona originale. È proprio questa separazione tra identità vocale e contenuto a rendere il consenso d’uso e le autorizzazioni più importanti della sola qualità della sintesi.
La creazione è gratuita, l’utilizzo viene fatturato a consumo
AWS non applica un costo per costruire la voce, ma addebita l’impiego del sintetizzatore secondo il modello pay-as-you-go di Amazon Polly. Nel comunicato non compare un prezzo unico in euro per minuto di audio: indicarne uno senza conoscere caratteri elaborati, listino applicabile e condizioni commerciali sarebbe fuorviante. La quota iniziale è di dieci voci clonate per account e per regione AWS, ampliabile su richiesta. La voce rimane associata all’account e alla regione in cui è stata creata, perciò un’organizzazione che lavora in più regioni deve generare e autorizzare separatamente le proprie copie. Amazon prevede inoltre la cancellazione della voce e dei relativi dati sintetici quando non servono più. La gestione non è soltanto creativa, ma riguarda inventario delle voci, autorizzazioni e durata del loro utilizzo.
Continua con: Block presenta Dessa, voce AI quasi umana che riapre il rischio delle truffe.
La clonazione in italiano apre opportunità, non elimina il rischio di impersonificazione
Il debutto di Amazon Polly rende più concreto l’impiego professionale delle voci sintetiche in italiano, ma il modello ad accesso ristretto non equivale a una disponibilità universale. Consenso dichiarato, cifratura, controllo IAM e watermark sono le salvaguardie previste da AWS; la loro presenza non dimostra che ogni possibile abuso sia impossibile. La distinzione conta soprattutto quando la voce sintetica viene utilizzata per comunicazioni verso clienti, lettori o cittadini, che potrebbero attribuire al parlante originale un testo da lui mai registrato. Il fatto nuovo è dunque duplice: la clonazione vocale entra in un servizio AWS utilizzabile anche nella nostra lingua e viene proposta come risorsa aziendale governata da autorizzazioni. La responsabilità di stabilire quando e per quali contenuti quella voce può parlare non scompare con l’automazione.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.